2x RTX 5060 Ti 对比 GB10:为什么 32 GB 显存不敌 128 GB 统一内存
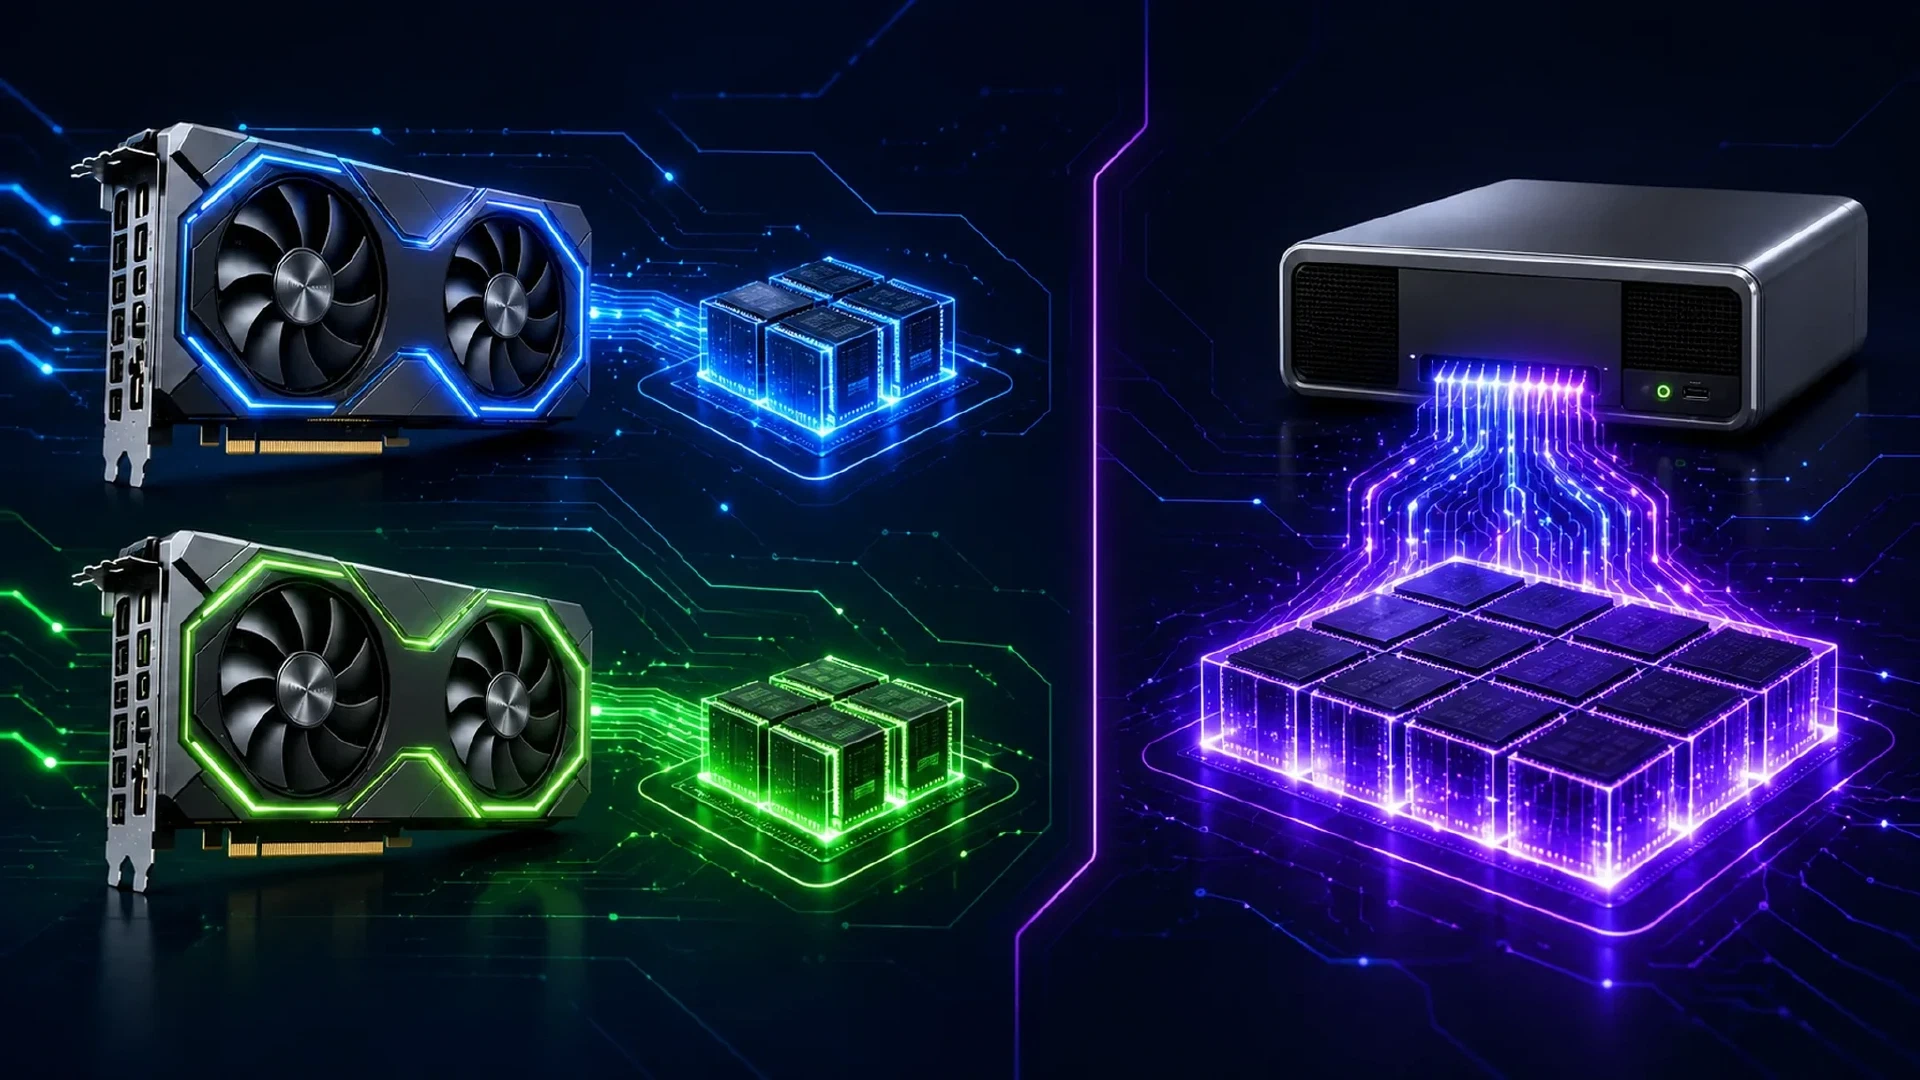
Table of Contents
在配件清单上,两张 RTX 5060 Ti 16 GB 显卡很有吸引力。 它们提供 32 GB 的总显存,并且擅长处理短上下文提示词。当你使用 27B 模型并搭配长上下文时,结论会改变。
NVIDIA GB10 系统使用 128 GB 一致性统一内存。NVIDIA 将 GB10 平台列为配备 128 GB LPDDR5x 统一内存和 140 W 芯片 TDP。RTX 5060 Ti 每张显卡使用 16 GB GDDR7、128 位内存接口,总图形功耗为 180 W。 NVIDIA RTX 5060 Ti 规格 和 NVIDIA GB10 规格 清楚展示了硬件差异。
核心结论很简单。 两张 16 GB 显卡不会组成一个快速的 32 GB 内存池。它们形成两个独立的 16 GB 内存池,并通过主机系统连接。对于大模型推理,容量不足和设备之间的数据移动比显卡数量更重要。
内存对比
| 系统 | 内存 | 内存模型 | 标称功耗数据 |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB 总计 | 两个独立的 GPU 内存池 | 360 W GPU 总功耗 |
| GB10 系统 | 128 GB | 一致性统一系统内存 | 140 W GB10 TDP |
GB10 的优势并非因为 128 GB LPDDR5x 内存拥有高端独立 GPU 的带宽。优势来自容量和内存位置。CPU 和 GPU 共享同一个地址空间,因此模型、运行时缓冲区、激活值和上下文数据不需要装入两个相互隔离的 16 GB 设备。
双卡系统面临更困难的内存放置问题。模型必须分布在两张卡上。推理运行时必须在两张卡之间移动数据。PCIe 流量增加延迟并占用带宽。根据 NVIDIA 的规格,RTX 5060 Ti 也不支持 NVLink。
基准测试结果
以下结果来自提供的 AI 基准测试报告。报告将一个未命名的双 GPU 系统标为 5060ti-x2,并将其与 GB10 系统对比。测试覆盖多个上下文长度下的 Qwen 和 GPT-OSS。
模型直接来自 Ollama。测试使用字面默认标签 qwen3.8:27b 和 gpt-oss:latest,没有选择自定义 Modelfile 或其他量化版本。5060ti-x2 系统使用 PCIe Gen4 x16,以及基准测试运行时可用的最新 NVIDIA Linux 驱动。
Qwen 提示词处理和生成
| 上下文 | 5060ti-x2 提示词 tok/s | 5060ti-x2 生成 tok/s | GB10 提示词 tok/s | GB10 生成 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
在 4K 上下文下,双卡系统的生成速度约为 GB10 的两倍。在 64K 下,领先幅度降至约 1.5 倍。在 128K 下,两套系统的生成速度大致相同。
在 256K 下,双卡配置不再显得占优。5060ti-x2 请求只达到 171,359 个实际提示词 token。生成速度降至每秒 1.2 token。GB10 以每秒 25.8 token 完成了完整的 256K 测试。
在测试得到的 256K 结果中,GB10 的生成速度约快 21.5 倍。 更重要的是,GB10 完成了请求的上下文长度。双卡系统没有完成相同的工作负载。
为什么总显存容量会误导
1. 模型看不到一张 32 GB 显卡
两张 GPU 不会把显存合并成一个本地地址空间。模型并行运行时会将层或张量分配到不同设备。每台设备仍需为分配到的权重、临时缓冲区和部分上下文状态留出空间。
因此,可用容量低于简单相加得到的总和。确切开销取决于模型格式、量化方式、推理后端、张量分割方式和上下文长度。
2. 生成过程中上下文内存会增长
模型权重只是内存预算的一部分。键值缓存,也就是 KV cache,会保存此前 token 的注意力数据。上下文越长,缓存所需内存越多。4K 测试不能预测 128K 或 256K 部署的表现。
提供的结果清楚显示了这个边界。随着上下文增长,双卡系统保持明显的提示词处理优势,但生成性能下降。GB10 从 4K 到 256K 的生成速度则保持在每秒约 26 到 29 token。
3. PCIe 传输会增加开销
当运行时在 GPU 之间移动激活值或张量时,传输会经过主机互连。这个过程会产生同步点,并为每一步增加延迟。当工作负载反复跨越设备边界时,惩罚会加重。
这不代表双 GPU 系统没有用。内存位置属于性能结果的一部分。只报告 4K 下的提示词处理速度,会忽略这项成本。
4. 功耗效率属于系统级优势
在本次对比中,GB10 功耗更低,同时为测试的长上下文工作负载提供更大的内存容量。两张 RTX 5060 Ti 的组合 GPU 功耗数据为 360 W,还没有计入系统其他部分。NVIDIA 将 GB10 的 TDP 列为 140 W。
GB10 用短上下文峰值速度换取容量、完成能力和更低的 GPU 功耗。 对于长上下文 Qwen 推理,这些取舍很重要。
5060ti-x2 系统的成本低得多
性能对比不会抹去价格差异。一台完整的双 RTX 5060 Ti 16 GB 工作站在 2026 年 10 月 10 日标价 $3,479。配置包括 Intel Ultra 7 265K、Z890 主板、32 GB DDR5、1 TB 存储、1,000 W 电源和两张 GPU。 查看完整的双 GPU 工作站列表 。
NVIDIA 美国市场将 128 GB DGX Spark 列价为 $6,950。列表包括 128 GB 一致性统一内存和 4 TB NVMe 存储,但显示系统缺货。 查看 NVIDIA 当前的 DGX Spark 列表 。
AMD Ryzen AI Halo Developer Platform 提供了另一个比较点。这款 Strix Halo 系统在 Micro Center 的标价为 $3,999.99,配备 128 GB LPDDR5x 统一内存和 2 TB 存储。Strix Halo 经常与 GB10 系统一样属于实用的本地 AI 类别,但独立测试经常显示 GB10 在吞吐量和软件成熟度方面领先。 查看当前 Micro Center Linux 列表 ,并 阅读 Strix Halo 与 GB10 的评测 。
| 完整系统 | 2026 年 10 月 10 日标价 | 价格差 |
|---|---|---|
| 5060ti-x2 工作站 | $3,479 | 基准 |
| AMD Ryzen AI Halo,Strix Halo | $3,999.99 | 贵 $520.99 |
| 128 GB GB10 DGX Spark | $6,950 | 贵 $3,471 |
GB10 提供更大的统一内存池、更低的功耗,以及更适合长上下文的架构。AMD 系统以约 $4,000 的价格提供同一类 128 GB 内存。5060ti-x2 工作站的价格约为标价 GB10 的 50%,还未计入税费和运费。不需要 NVIDIA 软件栈、但需要统一内存的买家,可以选择 Strix Halo 这一低成本替代方案。
这些是不同供应商的标价,不是受控的零售购物篮对比。对比中,5060ti-x2 系统的系统内存和存储也更少。价格差异仍然重要,因为两个列表都描述了完整且可用的计算机,而不是裸 GPU 价格。目前 RTX 5060 Ti 16 GB 显卡的列表价格约为 每张 $789 至 $830,远高于 $429 的上市建议零售价,因此即使当前 GPU 价格上涨,双卡系统的价格优势仍然存在。 查看当前 RTX 5060 Ti 价格 。
GPT-OSS 结果需要单独解读
同一份报告显示,5060ti-x2 在 4K 到 256K 的 GPT-OSS 生成结果都很强。GB10 完成了 4K 到 128K 的测试,但 256K GPT-OSS 测试标记为不支持。
不要使用 GPT-OSS 表格宣称某个系统普遍胜出。256K 下的测试没有覆盖相同范围。Qwen 结果提供了更清晰的长上下文对比,因为两套系统都报告了 256K 结果,尽管 5060ti-x2 运行只达到 171,359 个实际提示词 token。
这对 Qwen 3 27B 配置意味着什么
两张 16 GB 显卡组成的系统或许能在较小上下文下运行量化 27B 模型。基准测试没有否定这种用途。数据否定的是这一说法:32 GB 总显存不会提供与 128 GB 统一内存系统相同的实际余量。
模型能装入显卡,只能证明权重容量足够。 真正的内存需求是模型权重、活动上下文、KV cache、运行时缓冲区和操作系统余量的总和。上下文必须和模型一起装入内存。模型能加载,却没有空间处理工作对话,不算可用的长上下文配置。
这与 16GB 显存够不够进行严肃的本地 LLM 工作? 中的容量建议一致。该文将权重、上下文和运行时分配视为一个整体预算。 Qwen 27B 的 32GB 显存硬件指南 对双卡配置也得出相同结论。总容量不等于可用余量。
在部署 Qwen 3 27B 前,先回答四个问题:
- 请求的量化版本能否与运行时缓冲区一起装入? 仅模型权重不能定义内存需求。
- 上下文能否在 KV cache 压力不过高的情况下装入? 长提示词会改变结果。
- 运行时是否采用快速的设备分割方式? PCIe 传输和张量放置会影响每一个生成 token。
- 系统能否完成目标上下文? 快速的 4K 结果无法抵消失败的 256K 工作负载。
提供的测试回答了双卡系统的最后一个问题。该系统在 256K Qwen 请求中达到 171,359 个 token,生成速度为每秒 1.2 token。GB10 则以每秒 25.8 token 完成了 256K。
对于这个长上下文工作负载,当替代方案依赖 PCIe 跨越模型工作集时,统一内存是更好的架构。 PCIe 仍然是一种容量补救方案。PCIe 不会创造相同的内存池、延迟或传输路径。 本地 AI GPU 上下文指南 解释了为什么必须将模型权重、KV cache、工具输出和运行时缓冲区一起规划。 Ollama Qwen3.8 27B GPU 基准测试 也说明了为什么长上下文结果需要与短上下文解码数据分开看待。
结论
当目标是长上下文 27B 推理时,两张 RTX 5060 Ti 16 GB 显卡并不是 GB10 的好替代品。 它们在短上下文下提供更高的提示词吞吐量。它们也使用更多 GPU 功耗,并让运行时面对分割式内存布局。
在提供的结果中,GB10 的提示词处理速度更慢。该系统的功耗效率更高,提供四倍的总内存,并以可用的生成速度完成完整的 256K Qwen 测试。
如果你运行短提示词并重视提示词加载速度,5060ti-x2 有一个有限的适用场景。对于 27B 模型,更大的统一内存池是更好的选择,因为模型和上下文共享一个一致性的工作集。一旦 PCIe 传输进入推理路径,统一内存仍然更合适。
基准测试没有显示两张 RTX 5060 Ti 永远无法启动 Qwen 3 27B。数据说明了启动模型与高质量运行工作负载之间的差异。
基准测试限制
提供的报告列出了字面 Ollama 标签,但没有记录解析后的 manifest 摘要、模型版本、CPU、功耗测量或散热配置。报告还列出了 5060ti-x2 系统使用 PCIe Gen4 x16,以及测试时的当前 NVIDIA Linux 驱动。将这些数据视为一次观测到的系统对比,不要视为每一组 RTX 5060 Ti 和每一种 GB10 实现的普遍排名。
以上硬件规格来自 NVIDIA。性能数据来自为本文提供的基准测试数据。
参考资料
- Ollama Qwen3.8 模型库
- Ollama GPT-OSS 模型标签
- 16GB 显存够不够进行严肃的本地 LLM 工作?
- Qwen 27B 的 32GB 显存
- 本地 AI GPU 上下文指南
- Vast.ai 上的 Qwen3.8 27B GPU 基准测试
- 完整的双 RTX 5060 Ti 16 GB 工作站列表
- NVIDIA DGX Spark 美国市场列表
- AMD Ryzen AI Halo 128 GB Linux 列表
- Tom’s Hardware 的 Strix Halo 与 GB10 评测
- RTX 5060 Ti 当前价格
Related Posts