AI 网络安全认证:跟不上实践

Table of Contents
我们参加了考试,也通过了考试。拿到证书后,我仍感到失望,想具体说明原因。
这不是在指责项目的设计者。他们面对的材料并不完整。AI 安全作为一门学科还很年轻。攻击研究的发展速度超过了防御工具。治理框架先于工程指导出现。
问题在于,认证课程所教的内容,与真正保护生产环境中的 AI 系统所需的知识之间存在差距。
三个经常混淆的层次
说明缺少什么之前,先区分当前已有的内容。
第一层是治理。NIST AI Risk Management Framework(AI RMF 1.0,2023)、ISO/IEC 42001:2023 和 EU AI Act 等文件在组织和流程层面发挥作用。它们说明如何管理 AI 风险、建立监督机制并记录问责。这些文件有意聚焦治理,而不规定具体控制措施。这是设计如此。
第二层是威胁分类。MITRE ATLAS 以 ATT&CK 相同的格式记录针对 AI 系统的对抗战术。OWASP Top 10 for Large Language Model Applications 列出部署 LLM 时最相关的攻击类型。这些文件为攻击命名并说明攻击方式,但不规定防御措施。
第三层是技术指导,包括 Google Secure AI Framework(SAIF)、Microsoft AI Security SDL、OWASP AI Exchange、NIST AI 600-1(Generative AI Profile),以及 Anthropic、OpenAI、Meta 等供应商的安全文档。这些资料提供安全部署、评估实践和运行时控制方面的工程指导。
大多数 AI 治理认证会深入讲解第一层,以概述方式提到第二层,很少涉及第三层。
认证涵盖什么
目前提供的 AI 治理和安全认证,包括 IAPP AI Governance Professional(AIGP)、ISACA AI Fundamentals Certificate、ISO 42001 认证和 CompTIA AI+,涵盖的主题大致相同。
你会学习 NIST AI RMF,并了解如何将其四项职能 Govern、Map、Measure 和 Manage 对应到所在组织的 AI 部署。你会学习 EU AI Act 的风险级别,以及高风险系统的合格评定流程。你会学习如何把偏见、公平性、透明度和问责作为治理原则,也会学习如何编写 AI 治理政策和开展影响评估。
这些都是实用技能。组织需要理解治理框架的人,也需要能阅读 NIST AI RMF 并知道它要求建设什么的人。
认证课程没有同等深入讲授的内容包括:
- 攻击者当前如何入侵生产环境中的 AI 系统
- 提示注入的纵深防御在实际运行中是什么样,以及为什么单一控制无法消除提示注入
- 部署前如何验证模型完整性
- AI 红队测试包含哪些内容,以及如何确定测试范围
- 发布前如何评估模型面对对抗性输入时的行为
- 推理时的 AI 可观测性是什么
- AI 事件响应与标准 IR 操作手册有何不同
- 如何保护拥有工具访问权限和外部集成的 AI 智能体
NIST AI RMF 讲治理,不讲工程
NIST AI RMF 是一份结构完善的文件。NIST 将其设计为技术中立、行业无关,并适用于不同的 AI 开发方式,因此该框架能够广泛适用。
这也意味着框架不会针对具体攻击类型规定技术控制措施。如果组织全面采用 AI RMF,并将所有职能映射到 AI 部署,你会得到有记录的风险流程,但部署中的语言模型不一定具备抵御提示注入的防护。
NIST 承认这一点。2024 年发布的 NIST AI 600-1(Generative AI Profile)专门扩展 AI RMF,涵盖生成式 AI 和大型语言模型。它对提示注入、数据投毒和信息危害等风险的说明,比基础 AI RMF 更具体。如果认证只涵盖基础 AI RMF 而没有 AI 600-1,你就错过了与当前部署系统最相关的文件。
ISO 42001 与管理体系的比较
ISO 42001:2023 是 AI 管理体系标准,为组织层面的 AI 开发和部署治理提供结构。安全专业人员会发现它与信息安全标准 ISO 27001 有相似之处。
ISO 27001 得到广泛采用,但认证组织仍会遭到入侵。认证记录管理体系是否存在、是否遵循既定流程、是否接受审核。它并不证明该流程管理的系统能够抵御针对它们的攻击。
ISO 42001 提供组织纪律。获得认证说明 AI 流程已记录、经过审核并接受治理,但它不能证明部署的模型在对抗条件下会稳定输出、智能体会遵守既定信任边界,或微调模型使用了经过验证的训练数据。
ISO 27001 也存在同样的差距。在传统网络安全领域,我们学会了正视这一点。AI 治理认证存在相同的结构性局限,不应声称它们已经弥合了这个差距。
EU AI Act 规定结果要求,却没有工程规范
EU AI Act 按风险等级对 AI 系统分类:不可接受风险(禁止)、高风险(需要合格评定)、有限风险(承担透明度义务)和最低风险(没有具体要求)。
高风险系统包括用于关键基础设施、生物识别、就业筛选、教育和执法的系统。这些系统需要技术文档、人工监督和稳健性保障。该法明确要求高风险 AI 系统能够抵御通过对抗操纵改变行为的尝试。
这项要求写在法律文本中。该法有意规定预期结果,而不规定技术控制措施。对于所有部署环境,如何证明对抗稳健性,不同系统和用途尚无普遍认可的技术答案。
围绕 EU AI Act 设计的认证会教你对 AI 系统分类、编写技术文档和设计监督流程,也会为审计做准备。要通过工程工作构建符合稳健性要求的系统,属于认证课程目前没有覆盖的另一门专业。
AI 系统实际上面临哪些攻击
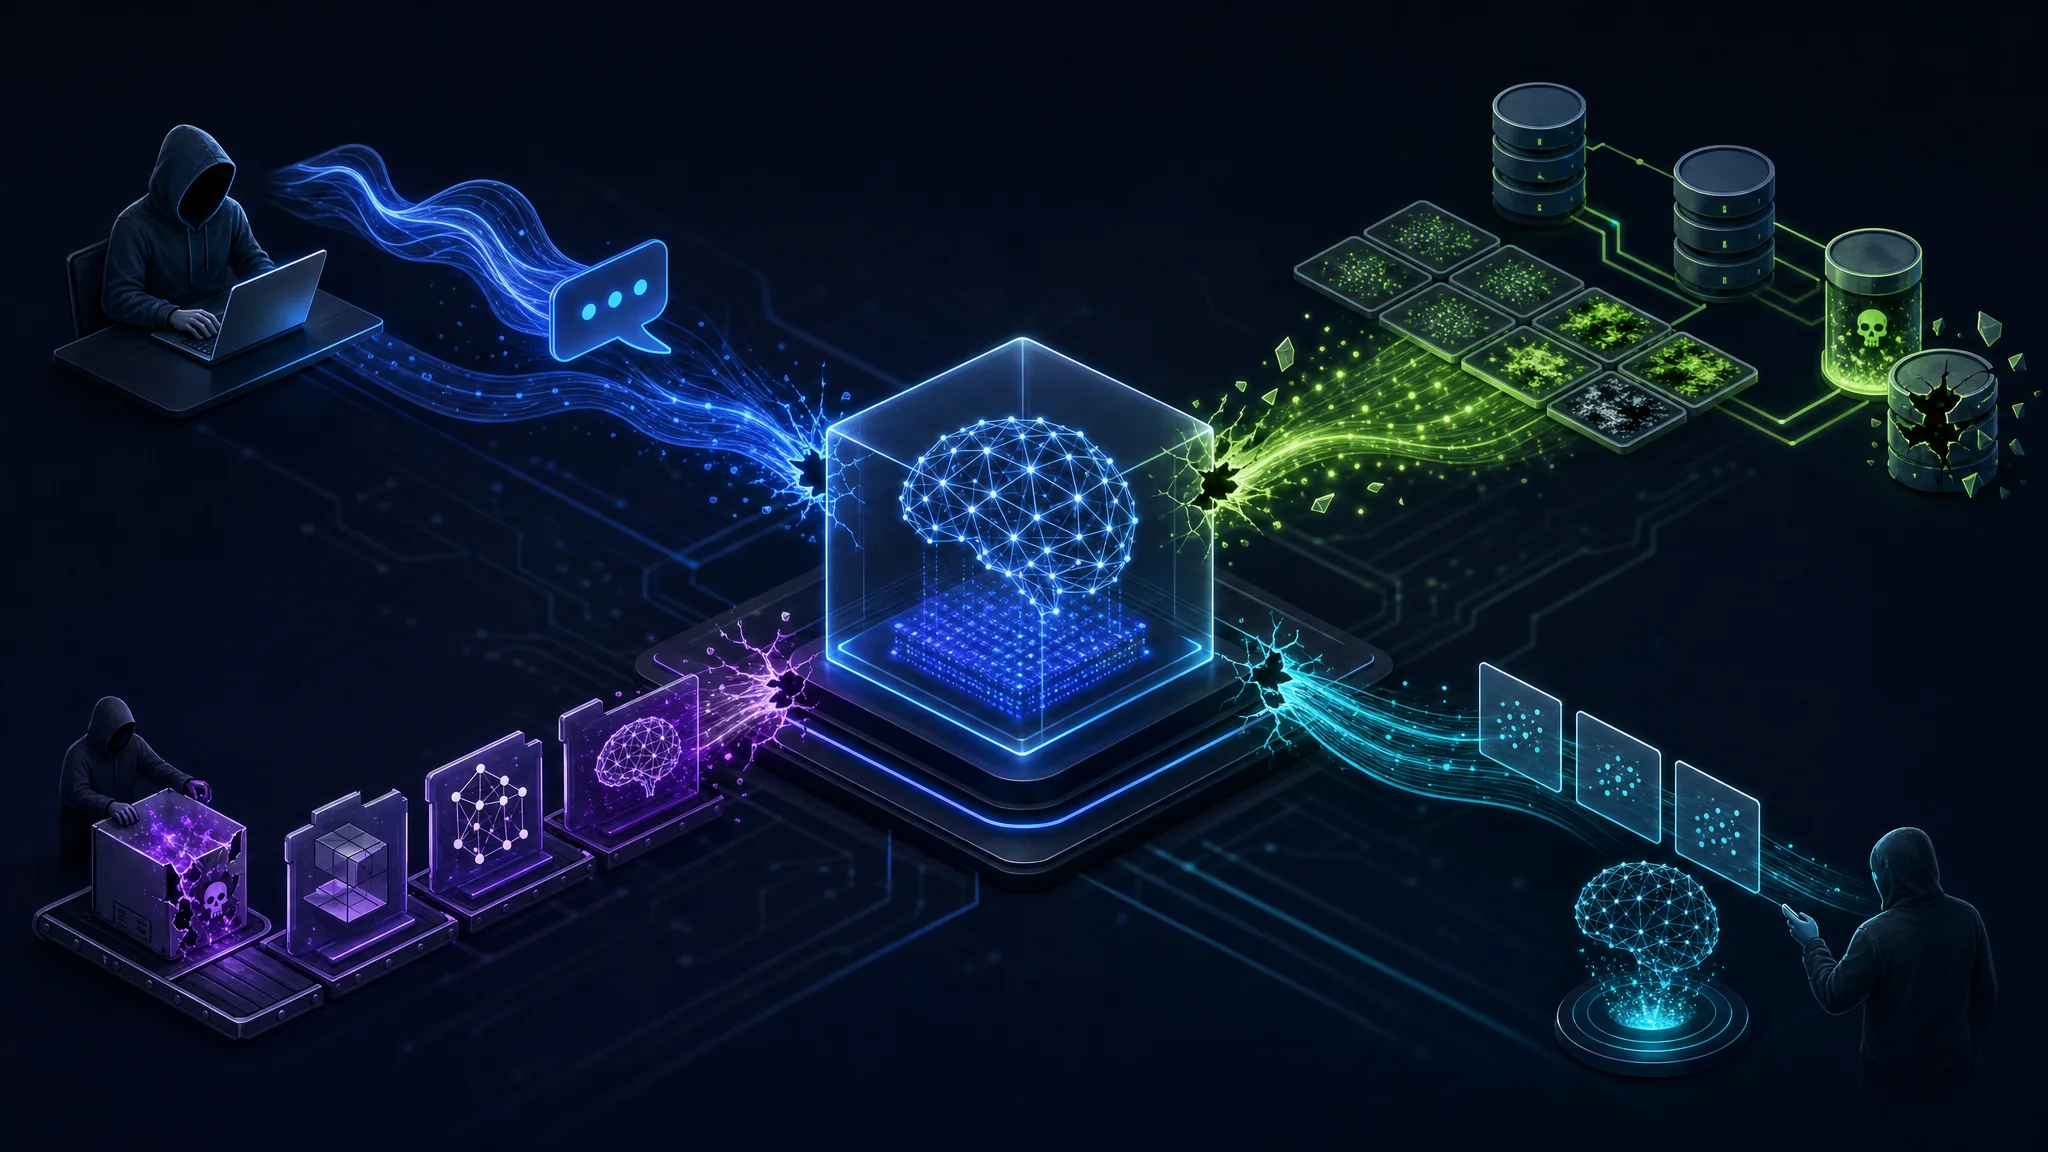
MITRE ATLAS 和 OWASP LLM Top 10 记录了实际运行中的威胁情况。这些资源以有用的细节列出攻击。治理框架提到威胁时抽象程度更高。以下内容来自这些专门的安全资料。
提示注入通过向语言模型提供输入,覆盖或操纵系统指令。直接注入会直接针对模型输入。间接注入会把恶意指令藏在模型检索、处理或总结的内容中。你的 RAG 流水线读取攻击者控制的文档,并执行其中隐藏的指令。你的浏览智能体访问攻击者控制的网页并遵循嵌入其中的要求。你的客户支持机器人总结一篇要求忽略安全指南的支持文章。
截至 2026 年,没有一种提示注入缓解措施能够在所有情况下奏效。纵深防御可以降低风险,包括输入过滤、输出验证、受限权限的工具范围、沙箱执行环境,以及重要操作的人类审批关卡。这些措施都无法消除这类攻击。NIST、OWASP、Anthropic、OpenAI、Google 和 Microsoft 都建议采用多层控制,而不是依赖单一方案。
训练数据投毒是将恶意样本加入训练数据,以降低模型表现、植入后门或设置触发条件行为。模型遇到特定触发输入前,通常看不出投毒是否成功。如果组织使用用户生成内容、检索文档或第三方数据集微调模型,却不验证其来源,就会面对这种风险。
模型供应链入侵是多数组织事后才考虑的威胁。模型仓库经常与模型权重一起分发可执行代码。不安全的 pickle 等序列化格式反复造成供应链风险。模型下载包还可能安装本身存在漏洞的依赖项。许多组织从公共仓库下载模型时,进行的供应链审查似乎远少于软件依赖项。其攻击面与 npm 相当,但相关安全文化还处于早期阶段。
模型提取允许攻击者反复向你的 API 发送推理查询,从而重建功能相近的模型。这既会造成知识产权损失,也让攻击者能够离线研究模型并开发更有针对性的攻击。
成员推断会让攻击者以不同置信度判断特定数据记录是否出现在训练集中,具体取决于模型架构和训练方式。使用个人信息训练模型的组织会因此面临隐私风险。
对抗性输入通过精心设计的扰动操纵模型输出。这种技术在图像分类中研究最多,但也适用于文本、音频和多模态系统。如果 AI 会判断欺诈、信用状况、医学影像或物理访问权限,就需要测试对抗稳健性,而不能只把它写进文档。
AI 系统的数据泄露也需要直接关注。RAG 流水线会暴露知识库文档,有时还会提供给无权访问的用户。系统指令泄露会暴露原本需要保密的运行细节。多租户 AI 部署需要隔离,传统应用安全工程师有时会低估这项要求。这些都是已部署系统中经常出现的实际风险。
AI 智能体彻底改变攻击面
大多数 AI 安全认证是在 AI 系统主要指聊天机器人和分类器时编写的。到 2026 年,企业 AI 越来越多地指智能体。
智能体与聊天机器人有一个重要的运行差别:它会采取行动。能够访问电子邮件系统、内部数据库、文件系统、浏览器和代码执行环境的智能体,不是功能更多的聊天机器人。它是一个依据语言模型输出运行、能够访问重要真实系统的自主进程。
OWASP 现在单独维护 Agentic AI Top 10,因为智能体的威胁模型与 LLM 聊天应用差异足够大,需要单独说明。
智能体环境中的提示注入不会导致一段不想要的文字回答,而会触发不想要的操作。检索文档中的间接注入会要求智能体删除文件、导出数据或发送电子邮件。后果不是回答不当,而是智能体对有权访问的系统执行未经授权的操作。
智能体的攻击面包括:
- 工具调用限制:智能体是否仅能使用完成每项任务所需的最少工具
- 凭据范围:智能体持有的凭据是否限制在每项任务所需范围内
- 操作可逆性:重要操作执行前是否需要人工审批
- 输出过滤:智能体输出触发后续操作前是否经过验证
- 沙箱:智能体的执行环境是否防止意外访问已连接的系统
大多数 AI 治理认证不会如此具体地讲授智能体安全设计。
Model Context Protocol 带来新的企业攻击面
Model Context Protocol(MCP)已成为连接 AI 智能体与外部工具、数据源和服务的常用标准。MCP 服务器会暴露智能体能够发现并使用的功能。集成速度快、灵活性高,但安全影响并不总能得到同等重视。
MCP 特有的风险包括:
- 恶意 MCP 服务器向智能体虚报功能,并执行非预期操作
- 工具投毒:合法 MCP 服务器返回攻击者控制的数据,并在本应是数据的输出中嵌入指令
- 权限过大的工具:MCP 集成持有超出任务需求的权限
- 信任边界混淆:智能体把附加 MCP 工具发来的指令视为与用户指令同等有效
部署 MCP 集成智能体的组织需要一套框架,用于评估 MCP 服务器的可信度、审核工具权限,并验证工具响应会被当作数据而非指令。
评估是认证课程跳过的实际工作
AI 红队测试和评估套件正在取代静态安全评估,成为部署前后了解 AI 模型风险的主要方式。
AI 红队测试包括:
- 针对已知攻击技术,对模型行为进行结构化对抗测试
- 使用成熟的提示攻击数据集开展越狱基准测试
- 通过扰动输入测量输出变化,测试对抗稳健性
- 在不同模型版本之间进行行为回归测试
- 根据已发布的评估套件开展安全基准评估
NIST、Anthropic、OpenAI、Microsoft、Google 和 CISA 都建议高风险系统在部署前进行 AI 专项红队测试。这正在成为标准要求,而非可选做法。
当前的 AI 治理认证都没有充分训练从业者为已部署模型或智能体确定红队测试范围、执行测试或解读结果。它们会说明红队测试是什么,却不教你如何开展。
AI 可观测性是独立的专业领域
传统安全日志无法直接套用于 AI 系统。在生产环境中监控 LLM 或智能体,需要收集不同的数据并采用不同的分析方式。
AI 可观测性基础设施包括:
- 用于检测异常和识别违反政策行为的提示与输出遥测数据
- 智能体的工具调用日志,记录调用了哪些工具以及使用了哪些参数
- RAG 流水线的检索质量监控
- 越狱尝试的检测和分类
- 监控输出一致性,以发现不同版本之间的模型漂移
- 对事实准确性重要的应用跟踪幻觉率
- 可能表明提示注入正在扩大上下文的延迟模式
这是一个新兴领域。2026 年部署 AI 的多数组织,对 AI 组件的可观测性远低于传统基础设施。多数治理认证都不会说明 AI 系统需要怎样的可观测性。
AI 事件响应不同于常规 IR
传统系统遭到入侵时,IR 操作手册涵盖遏制、取证和恢复。AI 事件会带来标准操作手册没有处理的问题。
在需要之前,你就应为以下问题准备操作手册:
- 如何判断模型是否在微调过程中遭到投毒
- 如何评估 RAG 检索是否被滥用,从而返回攻击者控制的内容
- 如何确认智能体是否执行未经授权的操作,以及操作范围有多大
- 如何验证第三方供应商的模型更新是否以安全相关方式改变了行为
- 如何确定事件发生前模型的行为,以便和事件后的行为比较
这些问题需要在事件发生前准备。你必须提前配置日志和遥测数据,也需要 AI 专项操作手册,为模型行为取证留出位置,而不只是记录网络流量和终端日志。
认证更新难题
认证落后于实践的一个结构性原因是:AI 安全的变化速度超出了认证更新周期。
Security+、CISSP 和 ISO 27001 涵盖的领域通常多年才发生变化。网络、终端和应用的核心攻击面相对稳定。AI 攻击技术却在数月内演变。2026 年的提示注入技术、对抗攻击方法和智能体攻击面,已经不同于 2023 年和 2024 年首批 AI 认证推出时的情况。
认证机构按周期更新材料。OWASP LLM Top 10 在发布后的第一年内就进行了重大修订。许多现有 AI 认证设计时,MCP 还不是企业级问题。多数现行认证课程推出之后,智能体式 AI 安全框架才出现。
这是结构问题,不代表制定者没有用心。你需要持续阅读一手资料,而不能把认证当成固定的知识集合。
AI 安全认证课程需要涵盖什么
认证课程要反映当前 AI 安全实践,就需要涵盖:
- 提示注入纵深防御:输入过滤、输出验证、工具范围限制、沙箱和人工审批关卡,并说明各项措施的已知局限
- 模型供应链验证:不安全序列化风险、SBOM 要求、来源文档和签名制品验证
- AI 智能体安全架构:信任边界、最小权限工具访问、操作可逆性和监控要求
- MCP 与外部集成安全:评估工具服务器可信度、审核工具权限,以及区分数据与指令
- 评估与红队测试:如何确定对抗评估的范围、有哪些基准与评估数据集,以及如何解读结果
- AI 可观测性:AI 系统需要哪些日志和遥测数据,如何用于事件检测与响应
- AI 专项事件响应:为 AI 事件预先制定计划、收集模型行为问题的证据,以及考虑 AI 系统特有的恢复需求
- 防止数据泄露:RAG 隔离、提示机密性、多租户访问控制和输出过滤
你现在应该做什么
如果你负责所在组织的 AI 系统:
阅读 OWASP Top 10 for Large Language Model Applications 和 OWASP Agentic AI Top 10。这些资料免费,而且比当前收费认证课程提供更多运行细节。
下次为 AI 组件开展威胁建模之前,先审查 MITRE ATLAS。在确定部署设计前,了解哪些对手战术适用于你的架构。
阅读 NIST AI 600-1。它专门扩展基础 AI RMF,用于生成式 AI;相比单独使用基础框架,它与 LLM 和智能体部署更相关。
查看 Google SAIF、Microsoft AI SDL 和 OWASP AI Exchange,了解治理框架未提供的工程指导。
验证组织部署的每个模型的来源。检查 model cards。在加载权重之前,扫描序列化格式,排查已知的漏洞利用类型。
逐一梳理环境中每个 AI 智能体拥有的访问权限。能够读写内部知识库、电子邮件和文件系统的智能体会放大提示注入的影响。将其凭据权限缩小到每项任务所需的范围。
任何模型或智能体进入高后果环境之前,都要进行 AI 专项红队测试。把它作为强制要求,而不是可选项。
现在就建立 AI 专项事件响应操作手册,不要等到需要时才开始。
将治理认证视为流程层的记录。它不是安全态势的证明。
参考资料
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

Related Posts