

2026 年本地 AI:27B 模型超越 Sonnet 4.6,硬件购买窗口正在关闭

Table of Contents
一个可下载、能在单张消费级显卡上运行的模型,如今在综合智能指数上超过了领先的 API 模型。 Qwen3.8 27B 是一款于 2026 年 8 月发布的开放权重视觉语言模型。它的三元重打包版本 Bonsai 2 27B 将相同权重压缩至 5.53 GiB。两者共同标志着本地推理不再是爱好者的妥协,而成为付费 API 的真正替代方案。
硬件购买窗口正在迅速关闭。内存价格处于二十年来最差水平,也在推高显卡价格。
本文介绍基准测试结果、两个模型的本质、开放模型仍然落后的方面,以及为什么未来十二个月不适合继续等待。
**你将获得:**根据工作负载选择模型和内存容量。购买前比较硬件成本、电费、上下文长度和实测吞吐量。基准测试无法预测模型在你的任务中的质量,也无法预测未来 GPU 价格。
简短结论
本地 27B 模型与接近前沿水平的付费 API 之间的智能差距已经消失。付费模型剩余的优势比价格差距所暗示的要窄。
三件事同时发生了变化:
- **开放 27B 模型取得了接近前沿的分数。**在相同评测套件中,Qwen3.8 27B 的 Intelligence Index 为 33.7,Sonnet 4.6 为 30.1。
- **三元量化将内存需求降低了约三分之二。**Bonsai 2 27B 可将完整 27B 模型装入 5.53 GiB,几百美元的显卡也能提供这一容量。
- **内存供应形势恶化。**2026 年初,传统 DRAM 合约价格环比上涨 90% 至 95%,这是 TrendForce 记录以来最大的季度涨幅,并将下一代 GPU 推迟到 2028 年。
现在购买或组装更省钱。这不是推销,而是供应数据所显示的情况。
观看单 GPU 测试
上面的说法值得用演示来验证,而不只是看表格。Bijan Bowen 在单 GPU 电脑上测试 Bonsai 2 27B,并提出问题:它现在是单卡可用的最佳模型吗?
关注输出质量,而不是每秒 token 数。速度是最容易改善的部分。
两个名字,一个模型
这里需要了解的两个模型并非竞争对手。它们使用相同权重,只是精度不同。
| Qwen3.8 27B | 三元 Bonsai 2 27B | |
|---|---|---|
| 是什么 | Qwen 的原始开放权重模型 | Prism ML 对 Qwen3.8-27B 进行的三元重打包 |
| 磁盘权重 | 18 GB | 5.53 GiB (PTQ1_0) 或 6.70 GiB (PQ2_0) |
| 参数 | 27B 密集模型 | 26.90B,相同架构 |
| 上下文 | 256K | 262,144 tokens |
| 视觉能力 | 支持,原生实现 | 支持,使用独立 CLIP 投影器包 |
| 工具调用 | 支持 | 支持 |
| 许可证 | Apache 2.0 | Apache 2.0 |
| 运行环境 | Ollama、llama.cpp、MLX | 仅限 Prism ML 的 llama.cpp 分支 |
Ollama 的 qwen3.8 模型库页面列出 27B 模型大小为 18 GB,支持 256K 上下文、视觉和工具调用,并为 Apple Silicon 提供独立 MLX 构建。Ollama 上的三元版本是 Prism ML 的 Apache-2.0 GGUF 包镜像,使用相同校验和重新发布。
**因此,实际问题不是选哪个模型。**而是你愿意花多少内存获得相同智能。三元版本只占约三分之一内存,损失很小。
基准测试对比
Artificial Analysis 使用同一套测试为两个模型打分。请逐行阅读结果,而不是只看摘要,因为两个模型各自在不同项目中领先。
| 基准测试 | Qwen3.8 27B | Claude Sonnet 4.6 | 领先者 |
|---|---|---|---|
| Intelligence Index | 33.7 | 30.1 | 开放模型 |
| Coding Index | 68.1 | 63.0 | 开放模型 |
| Agentic Index | 45.8 | 31.8 | 开放模型 |
| GPQA Diamond | 90.5% | 87.5% | 开放模型 |
| Humanity’s Last Exam | 33.9% | 33.6% | 开放模型 |
| AA-LCR(长上下文) | 82.0% | 80.0% | 开放模型 |
| GDPval-AA | 45.4% | 36.0% | 开放模型 |
| CritPt(研究物理) | 5.4% | 3.1% | 开放模型 |
| 不产生幻觉的比例 | 69.7% | 51.6% | 开放模型 |
| SciCode | 46.6% | 50.1% | Sonnet |
| AA-Omniscience 准确率 | 15.6% | 40.9% | Sonnet |
开放模型在十一项可比结果中的九项领先,包括全部综合指数。
开放模型领先之处
三个综合指数概括了主要结论。**智能指数 33.7 对 30.1,编程指数 68.1 对 63.0,智能体指数 45.8 对 31.8。**智能体指数差距最大。对于运行自动化多步骤工作流的人来说,这比单次提问更重要。
从百分位来看,Artificial Analysis 将 Qwen3.8 27B 的智能体指数评为优于 86% 的模型,编程能力优于 76% 的模型。Sonnet 4.6 分别处于第 68 和第 72 百分位。在研究生级科学推理方面,开放模型在 GPQA Diamond 上取得 90.5%。
Sonnet 4.6 仍然领先之处
有两项结果方向相反,而且都不容忽视。
**AA-Omniscience 衡量模型能否在第一次回答知识问题时答对。Sonnet 4.6 得分为 40.9%,开放模型为 15.6%。**这是事实可靠性上的巨大差距,也是为高级模型付费的最有力单项理由。
不产生幻觉的比例需要谨慎解读。Qwen 的 69.7% 对 Sonnet 的 51.6% 看起来是明确胜出,单独看确实如此。但该指标描述的是错误答案中没有编造信息的比例。准确率较低的模型会产生更多错误答案,因此两个百分比对应不同样本,不能直接比较。先看准确率这一行。
Sonnet 在 SciCode 上也以 50.1% 对 46.6% 领先,并公布了开放模型卡中没有列出的 IFBench 和 Terminal-Bench Hard 两项评测结果。这些结果无法比较。
两项坦诚的保留意见
**两款模型的发布时间相差六个月。**Sonnet 4.6 于 2026 年 2 月发布,Qwen3.8 27B 于 2026 年 8 月发布。用二月的前沿模型对比八月的开放模型,并非同条件比较。
**Sonnet 4.6 已不再是 Anthropic 的前沿模型。**Sonnet 5 和 Opus 5 现在都排在它之上。开放 27B 追上了 2026 年中期的旗舰模型,但没有追上当前最高端产品。声称相反是在过度解读表格。
基准测试衡量的是基准测试表现。唯一重要的分数是你的工作负载所得到的分数。
三元权重带来的变化
Bonsai 2 不是更小的模型,而是同一个 26.90B 模型采用更低数值精度。公开的 GGUF 元数据显示了这种取舍。
| 属性 | 数值 |
|---|---|
| 架构 | qwen35,混合注意力,每四层进行一次完整注意力,另有状态空间层 |
| 参数 | 26.90B |
| 块数 | 64 |
| 嵌入宽度 | 5120 |
| 注意力 | 24 个查询头、4 个 KV 头、键/值长度 256 |
| 上下文 | 262,144 tokens,RoPE base 为 1e7 |
| 权重格式 | 三元,组大小 128。PQ2_0 每个权重 2.13 位,PTQ1_0 为 1.75 位 |
| 视觉塔 | CLIP,460.73M 参数,作为独立投影器包发布 |
| 许可证 | Apache 2.0 |
**三元权重意味着每个参数只有三个可能值,而不是十六个。**压缩正是关键所在,因此完整 27B 模型占用 5.53 GiB,而不是 18 GB。
实测吞吐量
使用 llama-bench 在 32 GB RTX 5090 上测试,所有层均卸载到 GPU,启用 flash attention,取三次运行平均值:
| 数据包 | 权重 | 预填充 (pp512) | 解码 (tg128) |
|---|---|---|---|
| PQ2_0 | 6.70 GiB | 3802.74 tok/s | 135.41 tok/s |
| PTQ1_0 | 5.53 GiB | 1876.31 tok/s | 131.41 tok/s |
PQ2_0 的预填充速度比 PTQ1_0 快 2.03 倍,解码速度则在统计上相当。因此 PQ2_0 是合理的默认选择。只有当最后 1.2 GiB 内存很关键时才选择 PTQ1_0。使用 llama-server 和 65K 上下文时,单个流式请求的解码速度保持在 136.5 tok/s。
**日常使用中,解码速度最能被你感受到。**每秒 135 个 token 远超阅读速度。运行本地推理的理由不是延迟,因为托管 API 已经足够快。真正的理由是成本、隐私和控制权。
没人提到的陷阱
**标准版 Ollama 无法加载这些文件。**三元内核位于 Prism ML 的 llama.cpp 分支中。在 Ollama 0.34.2 上验证时,加载会报错 unsupported tensor "output.weight" size overflows。运行环境能识别 qwen35 架构,但其库中没有 pq2_0 或 ptq1_0,也没有 Hadamard 激活运行环境。
还有第二个陷阱,最好在浪费一晚之前了解。**这个系列的 F16 包看起来是安全的备用方案,其实不是。**其中的 tensor 是普通 F16 和 F32,因此能够解析并加载,不会报错,随后却会解码出不连贯文本。权重位于 prism.hadamard.* 元数据所声明的旋转基底中,运行环境必须应用对应旋转,否则只会输出乱码。50.1 GiB 的 F16 包也无法完整卸载到 32 GB 显卡上。
下载前先看模型卡。社区镜像并非受支持的构建版本,页面对此有明确说明。
背后的 MoE 浪潮
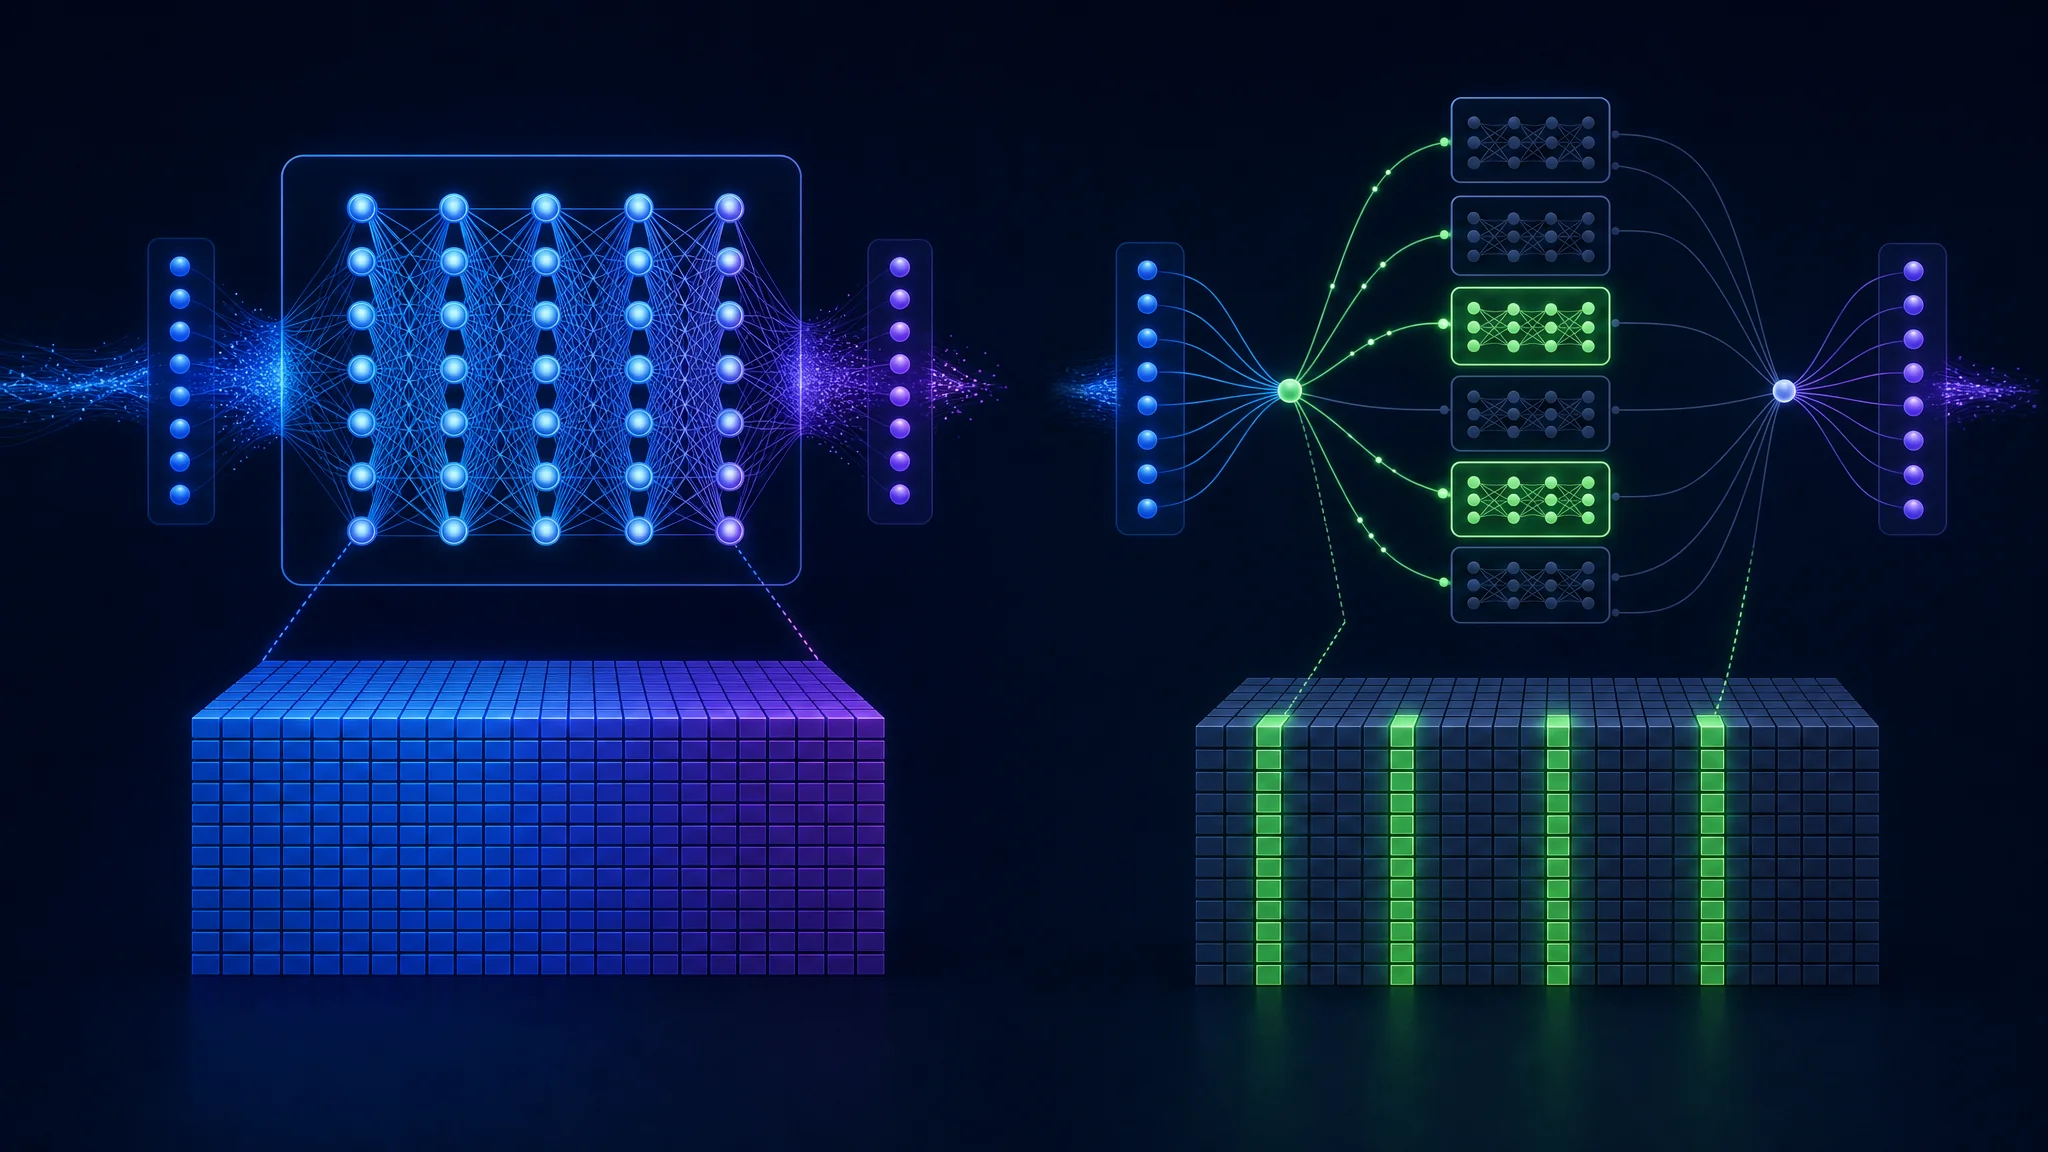
密集型 27B 模型只讲了一半。混合专家模型会针对每个 token 激活一小部分参数,这会再次改变成本计算。
| 模型 | 总参数 / 激活参数 | 上下文 | 说明 |
|---|---|---|---|
| Qwen3.8 2.4T A95B | 2.4T / 95B | 1.0M | Qwen3.8 Max 的开放权重同系列模型 |
| Qwen3.6 35B A3B | 35B / 3B | 262K | Apache 2.0,混合稀疏 MoE |
| Qwen3 Coder Next | 80B / 3B | 256K | 开放权重,面向持续运行的编程智能体 |
**本地工作值得关注 Qwen3 Coder Next。**它共有 80B 参数,但每个 token 只激活 3B,适合在 CLI 和 IDE 环境中部署持续运行的智能体。激活 3B 参数的模型以 3B 模型的速度生成,同时利用 80B 的存储能力。上游说明称,其表现可媲美使用多出 10 到 20 倍激活计算量的模型。
密集型 27B 是当前稳妥的选择。稀疏模型的效率曲线仍在改善。
硬件购买窗口正在关闭
这是故事中带有截止时间的部分。
本地推理刚变得便宜,它依赖的内存就开始涨价。这两种趋势正在碰撞,零售价格已经显现出影响。
内存价格发生了什么
2026 年第一季度,传统 DRAM 合约价格环比上涨 90% 至 95%,是 TrendForce 有记录以来最大的季度涨幅。同一时期,NAND 闪存上涨了 55% 至 60%。
压力没有减轻。TrendForce 数据显示,第二季度 DRAM 又上涨 58% 至 63%,NAND 上涨 70% 至 75%。第三季度涨幅放缓,DRAM 上涨 13% 至 18%,NAND 上涨 10% 至 15%,这不是缓解,而是在两个创纪录季度的基础上继续通胀。
原因是结构性的,而非周期性的。AI 数据中心建设消耗了原本供应手机、笔记本和游戏主机的内存产能,内存厂商优先分配给利润更高的订单。跟踪模组供应的分析师预计,2027 年供应给模组厂商的 DRAM 芯片将减少 70% 以上。
**Intel 首席执行官给出了具体数字。**在 2026 年 9 月 15 日于圣克拉拉举行的 AI Infrastructure Summit 上,Lip-Bu Tan 表示,内存价格相较以往水平已上涨“五倍、六倍、七倍”。他警告称,内存如今占低价笔记本物料清单的 70% 至 80%。他还单独表示,2028 年之前不会缓解。
关于 DRAM 晶圆与先进逻辑晶圆单位面积价格的独立报道提出了一项重要保留意见。现货价不是合约价,DDR5 现货采购规模很小,因此该比较只能说明趋势,并非定论。但整体方向没有疑问。
对显卡的影响
内存占显卡物料成本的很大一部分,因此 DRAM 价格会直接推高 GPU 价格。
| 显卡 | 2025 年初 | 2026 年 9 月 |
|---|---|---|
| Nvidia RTX 5090 | $1,999 | 超过 $5,000 |
| Asus RTX 5080 | $1,199 | $1,595 |
| AMD RX 9070 XT | 约 $830 | 超过 $1,037 |
这些涨价在 2026 年分几轮协调发生,并非孤立波动。Nvidia 于 1 月涨价,5 月再次专门提高 RTX 5090 的价格,并在年内稍后又涨了一次。AMD 于 8 月跟进,对部分 Radeon 显卡和 GDDR6 内存套件至少涨价 10%,并直接归因于内存成本。
**下一代不是按期发布,而是延期。**由于内存供应有限,Nvidia RTX 60 系列目前预计要到 2028 年,2027 年将完全跳过。
你今天买的显卡面对的不是明年更便宜的显卡,而是它自身更贵的版本。
为什么等待会更贵
硬件方面的常见建议是等下一代产品。在内存供应受限的市场中,这个建议对你不利。
三个事实支持这个结论。
**价格已经上涨,并且还在继续上升。**DRAM 合约价格单季度上涨 90% 至 95%,不是会在下季度逆转的小波动。TrendForce 预测第三季度还会上涨,而不是下跌;Intel 首席执行官也预计要到 2028 年才会缓解。
**没有值得等待的 2027 年产品。**如果下一代消费级 GPU 延期至 2028 年,等待策略就延长到两年。这几乎耗掉一个完整硬件升级周期,却没有任何回报。
**这些模型已经足够好。**这是 2026 年发生的变化。两年前,本地硬件明显无法提供相同体验。如今,同样的预算可以买到每秒生成 135 个 token、支持 262K 上下文的 27B 模型,并在综合智能指数上超过付费 API 模型。
如果你一直在等本地模型变好,现在不用再等了。如果你等硬件降价,供应数据表明要等到 2028 年。
该组装什么
三元权重降低了需求,因此按上述模型选择硬件很简单。
| 档位 | 内存 | 可轻松运行的内容 |
|---|---|---|
| 入门 | 8 至 12 GB VRAM | 5.53 至 6.70 GiB 的三元 27B,并为上下文留出空间 |
| 实用 | 16 至 24 GB VRAM | 完整 18 GB Qwen3.8 27B,或以长上下文运行三元包 |
| 舒适 | 32 GB VRAM | 以完整 262K 上下文运行三元 27B,或运行激活 3B 参数的 80B MoE |
| 统一内存 | 64 至 128 GB | 在 Apple Silicon 或统一内存台式机上运行更大的稀疏 MoE 模型 |
几条实用建议比档位表更重要:
- **买内存,不要追旗舰 GPU。**5.53 GiB 的三元包让入门配置真正可用。以 2026 年的价格,与其追逐高端显卡,不如把差价花在系统 RAM 和存储上。
- **统一内存系统更划算。**配有 64 GB 或更多共享内存的电脑,运行更大的稀疏模型时,成本只是同容量独立显卡的一小部分。
- **功耗和散热很重要。**运行数小时推理的电脑,与运行几分钟基准测试的电脑表现不同。
- **让三元包与小模型配合运行。**3B 模型回答简单问题,27B 处理难题。
高级模型何时仍然值得付费
高级档的理由确实存在,但比营销宣传所说的范围更窄。
**诚实的答案是事实可靠性。**Sonnet 4.6 的 AA-Omniscience 准确率为 40.9%,开放 27B 模型为 15.6%。如果错误答案会让你失去客户、影响诊断或损害法律立场,25 个百分点的准确率差距比任何综合指数都重要。
**长链条智能体任务是第二个理由。**Sonnet 4.6 在 Terminal-Bench Hard 上为 53.0%,在 τ²-Bench Telecom 上为 75.7%,这些测试衡量持续使用工具和多轮智能体行为。开放模型卡没有可比数据,这种缺失并不令人放心。
**第三个理由是运维。**托管 API 不需要更新驱动、处理量化问题、跟踪 llama.cpp 分支,也不需要修正旋转权重基底。其他人负责服务可用性,也在凌晨三点接到警报。
值得提出的问题
高级档在企业之外还有什么用途?
**对于要求知识可靠的工作,它仍然有价值。**研究、法律分析、医疗问题、金融建模,以及任何一次自信但错误的回答都代价高昂的任务。这是一个真实类别,准确率差距也是付费的真实理由。
**对于生成类工作,付费理由正在迅速变弱。**起草、总结、重构代码、重新格式化数据、分类文档和运行自动化流程,都是在信任输出前会先验证结果的任务。如果人员或测试套件先检查结果,准确率差距的代价就很小。对这些工作,当 33.7 指数的模型可以在你已有的硬件上免费运行时,很难证明按 token 为 30.1 指数付费合理。
**决策重点已从能力转向后果。**两年前,问题是本地模型能不能完成工作。今天,问题是出错的代价是什么,以及你如何发现错误。
企业级溢价买到的是可靠性、合规能力和由别人承担的轮值支持。其他人付费购买的差异,在测试套件运行后就不再重要。
要点
- 本地 27B 模型如今在综合智能指数上超过 Claude Sonnet 4.6,得分为 33.7 对 30.1,并在编程、智能体任务、长上下文和研究生级科学推理方面领先。
- Sonnet 4.6 在事实准确性上仍然领先,AA-Omniscience 得分为 40.9% 对 15.6%,这是高级模型最有力的剩余理由。
- **三元量化让本地运行变得实用。**Bonsai 2 27B 以 5.53 GiB 运行相同的 26.90B 模型,而不是 18 GB,且两者都采用 Apache 2.0 许可证。
- **标准版 Ollama 无法运行三元包。**它们需要 Prism ML 的 llama.cpp 分支,F16 备用包会悄悄输出不连贯文本,而不是报错。
- RTX 5090 上实测解码速度为每秒 135 个 token,远超阅读速度。
- **内存价格是现在采取行动的原因。**2026 年 DRAM 合约价单季度上涨 90% 至 95%,新一代消费级 GPU 推迟到 2028 年。
- RTX 5090 在不到两年内从 $1,999 涨到超过 $5,000,其他档位也随之涨价。
下一步
- 下载模型并用自己的工作负载进行测试: Ollama 上的 Ternary Bonsai 2 27B
- 如果内存足够,获取完整精度的原始权重: Ollama 上的 Qwen3.8
- 在组装电脑前先试用模型,使用免费的托管端点: OpenRouter 上免费的 Qwen3.8 27B
- 使用相同提示词与付费方案对比: OpenRouter 上的 Claude Sonnet 4.6
- 根据上方内存表确定所需档位,并先买内存,再买显卡。
- 如果有闲置的 Raspberry Pi,查看它能否运行更小的模型: Raspberry Pi 4 或 5 能运行哪些 AI 模型?
相关文章
| 文章 | 内容 |
|---|---|
| Raspberry Pi 4 或 5 能运行哪些 AI 模型? | 本地推理的入门范围,以及小型开发板实际能处理什么 |
| 为 Meshtastic 构建保护隐私的 AI 助手 | 在离网硬件上运行本地助手,隐私不可妥协 |
| ECC 内存在减少数据损坏中的作用 | 大模型存放在内存中时,内存质量为何更重要 |
| 什么是家庭实验室,你是否需要一个? | 为会发热的设备规划空间、电力和散热 |
参考资料
- Ternary Bonsai 2 27B - Ollama 模型镜像
- Qwen3.8 - Ollama 模型库
- Qwen3.8 27B(免费)- OpenRouter 基准测试和价格
- Claude Sonnet 4.6 - OpenRouter 基准测试和价格
- Bonsai 2 27B 首次测试:它是单 GPU 最佳 AI 模型吗?- Bijan Bowen
- Artificial Analysis - 独立模型评测
- TrendForce - DRAM 和 NAND 合约价格预测
- 按单位面积计算,内存芯片现在比计算芯片更贵 - Tom’s Hardware
- DRAM 创纪录上涨 95%,GPU 降价延至 2028 年 - Tech Insider
- Intel 的 Tan:内存涨价 7 倍,2028 年前不会缓解 - shattered.io
- Prism ML 的 llama.cpp 分支 - 三元内核
- Ternary-Bonsai-2-27B-gguf - 上游权重

Related Posts
This article refers to other articles we've written:
- 哪些 AI 模型能在 Raspberry Pi 4 或 5 上运行?
根据 Raspberry Pi 4 和 5 的实测结果,按内存、速度和工作负载选择本地语言模型,从小型 LFM2.5 到 3B 及更大模型。
- 为 Meshtastic 构建保护隐私的 AI 助手
介绍为 Meshtastic 构建本地 AI 助手的实践经验,涵盖私密配置、排队处理的 TCP 访问、信息检索工具和更安全的仪表板。
