根据完整回答、能力保留、上下文占用、量化方式和 VRAM 需求比较本地模型变体。
 #本地 LLM
#vram
#Ollama
#qwen3.8
分十个实用阶段搭建家庭实验室,从全网 DNS 过滤到本地 AI,并介绍各阶段的硬件、成本、技能和取舍。
 #家庭实验室
#Docker
#Tailscale
#Ollama
#本地 AI
我对 Hermes 模型的建议来自在 RTX 5060 Ti、RTX 2000E Ada、RTX 3060 Ti 和 RTX 3070 系统上进行的长上下文、工具、流式输出和视觉测试。
 #llama.cpp
#Ollama
#qwen3.8
了解经过验证的按需加载本地 AI 集群,以及使用 Hermes、LiteLLM、Tailscale Aperture 和 Pearl 挖矿的 T0 至 T4 控制平面。
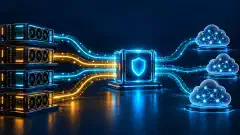 分层智能体集群将每项任务发送给合适的模型,空闲 GPU 则返回挖矿任务#Tailscale
#llama.cpp
#Ollama
#本地 LLM
#自托管 AI
从模型选择、本地推理、价格、权限、项目说明和日常编程流程等方面比较 OpenCode 与 Claude Code。
 #AI 编程工具
#本地 AI
#Ollama
#代理权限
#自托管 AI